Caso studio data · Agosto–ottobre 2024
Analisi social di iPhone 16
Uno studio end-to-end su come sono cambiati oltre 230.000 commenti YouTube prima, durante e dopo l'annuncio di iPhone 16.
- commenti analizzati
- 230k+
- video più l'evento live
- 1.000
- F1 del classificatore sul test
- 0,91
- archi nella rete post-evento
- 989k
La domanda
Cosa cambia quando l'attesa diventa un annuncio di prodotto?
Ho usato l'evento del 9 settembre come punto di separazione. L'obiettivo non era soltanto contare commenti positivi e negativi, ma collegare linguaggio, spam, account anomali e struttura delle comunità in tre finestre temporali.
La pipeline
Dalla raccolta via API alla valutazione dei modelli e ai grafi.
01
Raccolta dati
Video, commenti, live chat e dati pubblici degli account prima, durante e dopo l'evento.
02
Classificazione spam
Feature engineering, etichettatura semi-supervisionata, validazione annidata, scelta e tuning del modello.
03
Emozioni e sentiment
Un transformer pre-addestrato ha trasformato emozioni per commento in sentiment per argomento.
04
Anomaly detection
Isolation Forest ha individuato comportamenti insoliti da segnali di engagement e pubblicazione.
05
Network science
Grafi di co-commento per studiare centralità, assortatività, clustering e comunità Louvain.
Risultati selezionati
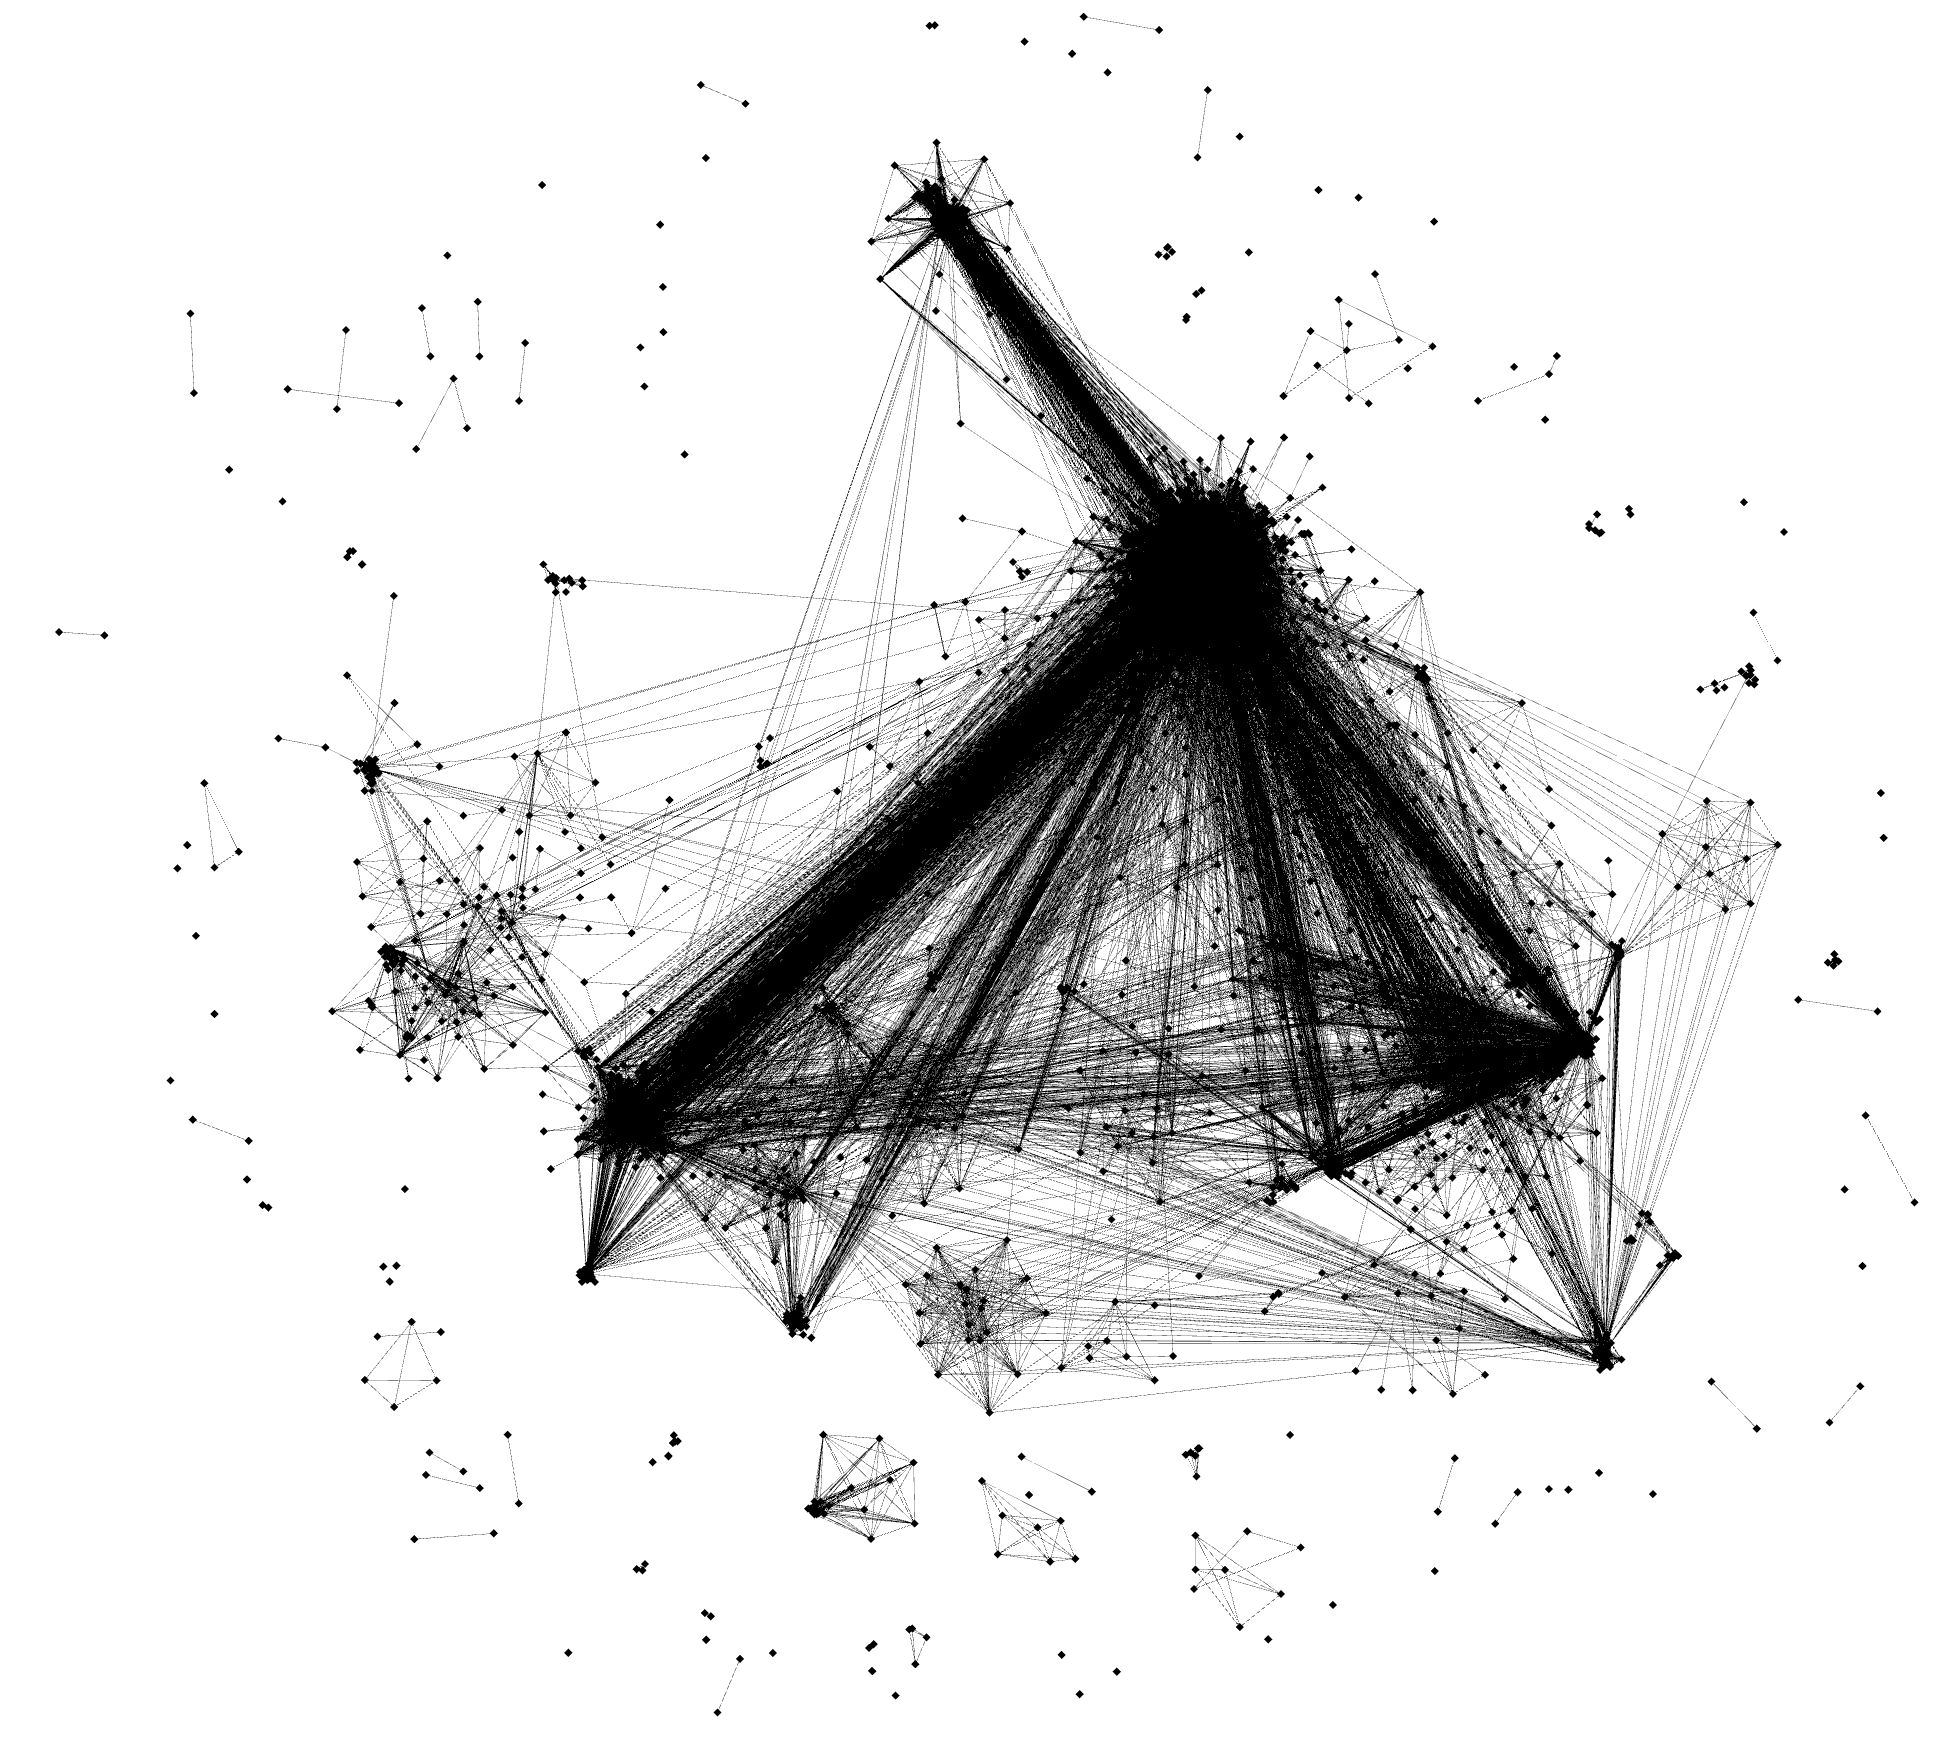
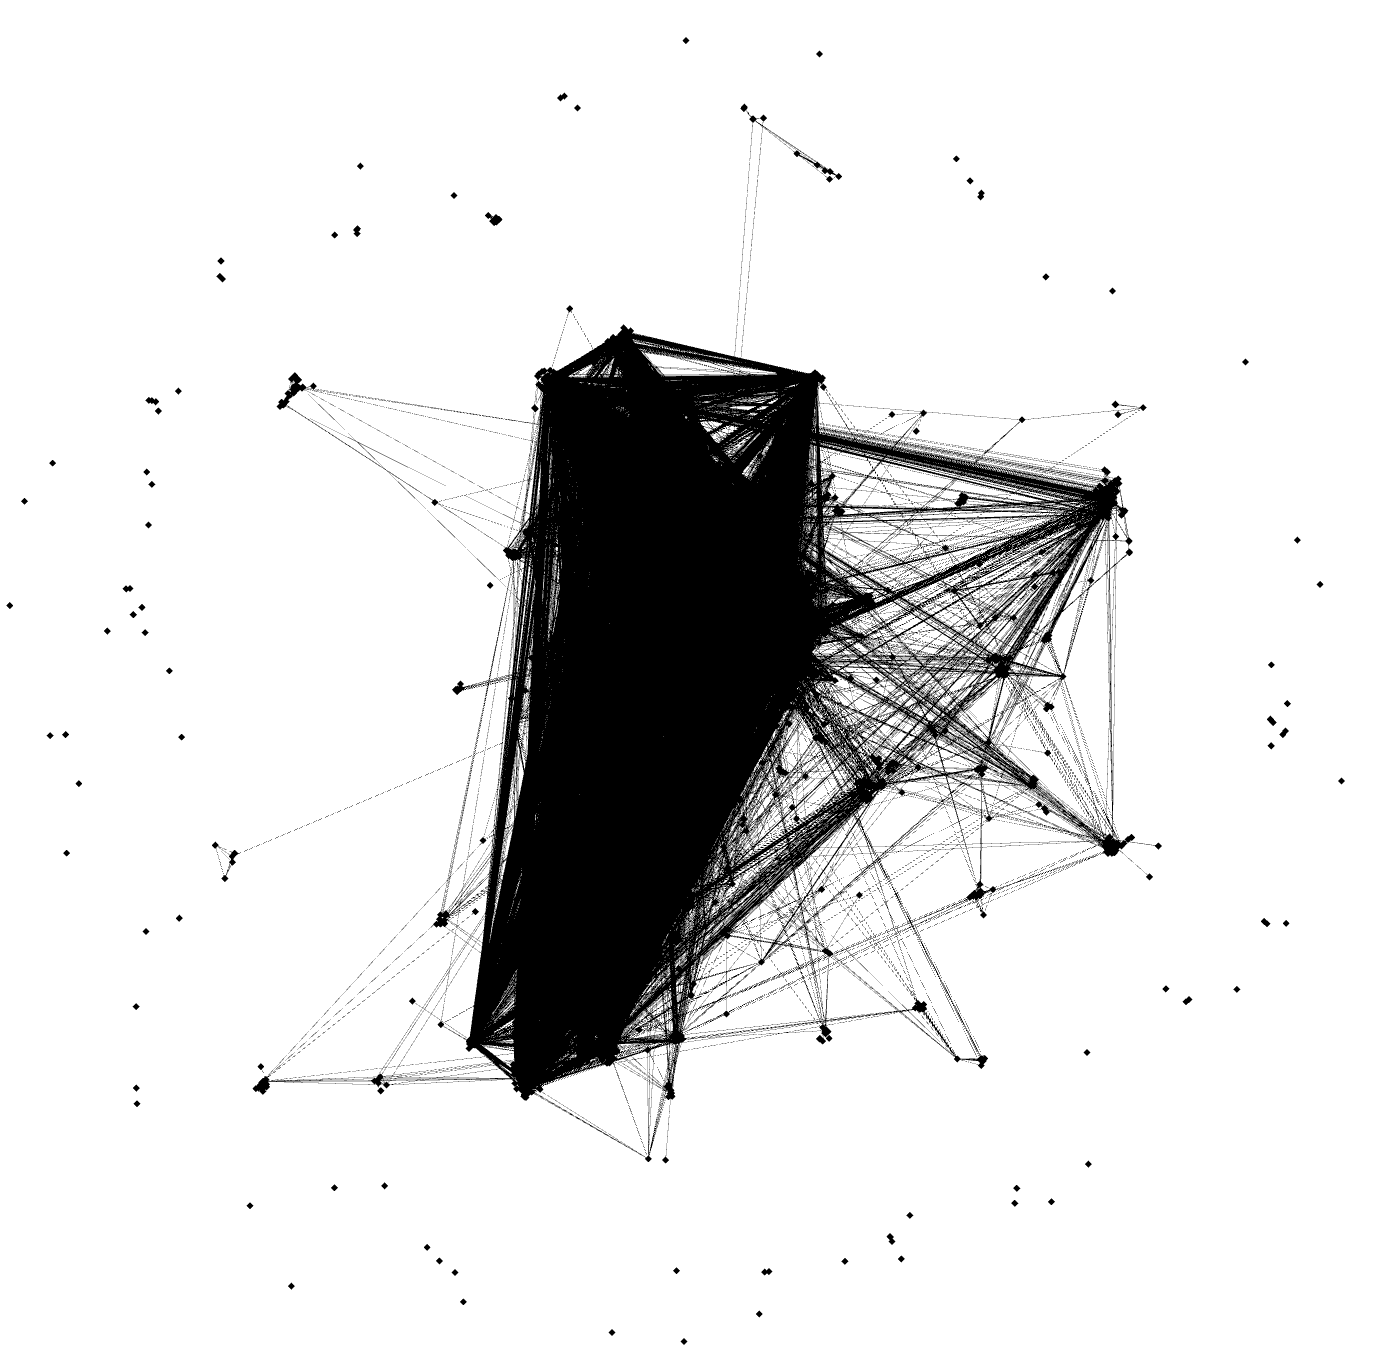
La rete osservata è cresciuta, con un clustering locale maggiore.
| Metrica | Prima | Dopo |
|---|---|---|
| Quota spamDurante la live era più bassa: 1,57%. | 4,41% | 4,70% |
| Nodi della retePiù commentatori unici nella rete dei video condivisi. | 4.190 | 7.789 |
| Archi della reteLe relazioni di co-commento sono cresciute nettamente. | 55.778 | 989.232 |
| TransitivitàI cluster locali sono diventati molto più densi. | 0,324 | 0,690 |
Interpretazione e limiti
Cosa possiamo concludere dai dati.
La quota di spam stimata è simile prima e dopo l’evento (4,41% e 4,70%). La live ha una quota inferiore (1,57%), ma soltanto 1.907 commenti: una base molto più piccola rispetto ai 96.929 prima e ai 131.381 dopo.
Un arco collega utenti che commentano gli stessi video, non necessariamente utenti che interagiscono tra loro. Dimensione del campione e popolarità dei video influenzano la rete. Questi risultati descrivono il campione YouTube, senza stabilire causalità o rappresentare l’opinione pubblica.
L’F1 di circa 0,91 riguarda il classificatore spam sul test, non l’accuratezza del sentiment o dell’intera pipeline. I notebook conservano gli output originali; riprodurre l’analisi storica richiede i dataset corrispondenti, non inclusi nel repository pubblico.
Cosa dimostra
Il valore è collegare i metodi, non soltanto eseguire modelli.
Il progetto passa dalla raccolta via API al supervised learning, dall'NLP con transformer all'unsupervised detection e all'analisi dei grafi. Ho anche documentato l'incertezza: campionamento della piattaforma, dataset live più piccolo, bias dei modelli e differenza tra pattern osservato e causalità.
Il repository pubblico contiene notebook ripuliti, istruzioni, visualizzazioni selezionate e la presentazione completa di 52 slide. Credenziali e dati grezzi degli utenti sono esclusi.
Contatti
Parliamo di lavoro, collaborazioni o idee da costruire.
Se stai valutando il mio profilo, vuoi propormi una collaborazione o hai un problema operativo da risolvere, scrivimi. Possiamo partire dal contesto, anche senza avere già tutte le risposte.
Oppure scrivimi diretto diego.webwork@gmail.com
Verona e Nord Italia. Disponibile per lavoro e progetti freelance. Disponibile al trasferimento.